Tester un agent vocal : figer la conversation, tester une seule phrase
Pourquoi un agent vocal est si difficile à tester, et comment goldenline m'aide à modifier son prompt sans tout casser.
Le contexte
Depuis quelque temps, je construis un agent vocal qui prend des commandes au téléphone : le client parle, un modèle de langage (LLM) choisit la réponse, et une voix de synthèse la prononce.
Ce qui décide du comportement de l’agent, c’est surtout son prompt : un texte de règles que le modèle relit à chaque réponse. L’écrire est facile. Le modifier sans rien casser, beaucoup moins.
Les difficultés
Le modèle ne répond pas toujours pareil
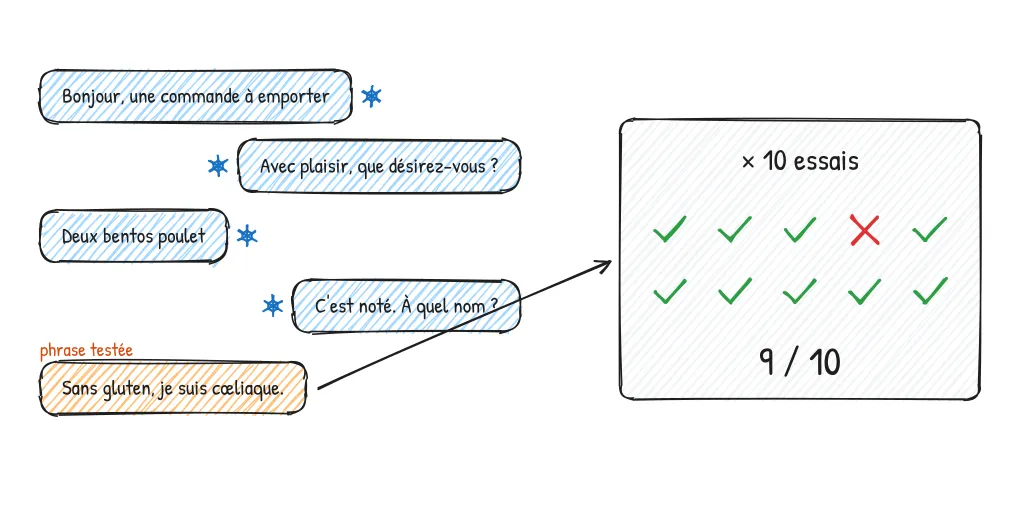
La même phrase ne donne pas toujours la même réponse. Un test qui passe une fois ne prouve donc rien : une règle peut être respectée 8 fois sur 10, et ce sont les 2 autres fois qui posent problème.
Corriger une règle en casse une autre
Le prompt grandit par accumulation : un problème, une règle de plus. Mais l’ancienne règle qui disait presque la même chose reste en place, et le modèle doit choisir entre les deux, sans que rien ne dise laquelle gagnera. Ça ne se voit pas en relisant le prompt, seulement en mesurant.
Les appels simulés sont lents, et le faux client se trompe aussi
Simuler des appels complets, avec un deuxième modèle qui joue le client, prend du temps et coûte cher. Quand quelque chose rate, impossible de rejouer exactement la même situation. Et le faux client fait ses propres erreurs : on ne sait plus qui on teste.
Le code rattrape le modèle… et embellit les chiffres
J’ai ajouté des garde-fous dans le code pour bloquer certaines mauvaises réponses. Très bien pour les vrais clients, mais dans les tests, le résultat final est bon alors que le modèle s’était trompé. Je comptais ces rattrapages comme des réussites du modèle.
Les tests vieillissent sans prévenir
Une conversation enregistrée puis rejouée telle quelle ne reste pas valable longtemps : le code et le prompt changent. Un vieux test peut continuer à passer alors qu’il ne teste plus rien de réel.
Comment goldenline m’aide
J’ai fini par construire un outil pour ça, puis je l’ai extrait de mon projet et publié en open source : goldenline.
L’idée : figer le début d’une conversation, et ne tester qu’une seule phrase du client.
Figer l’historique, pas le code
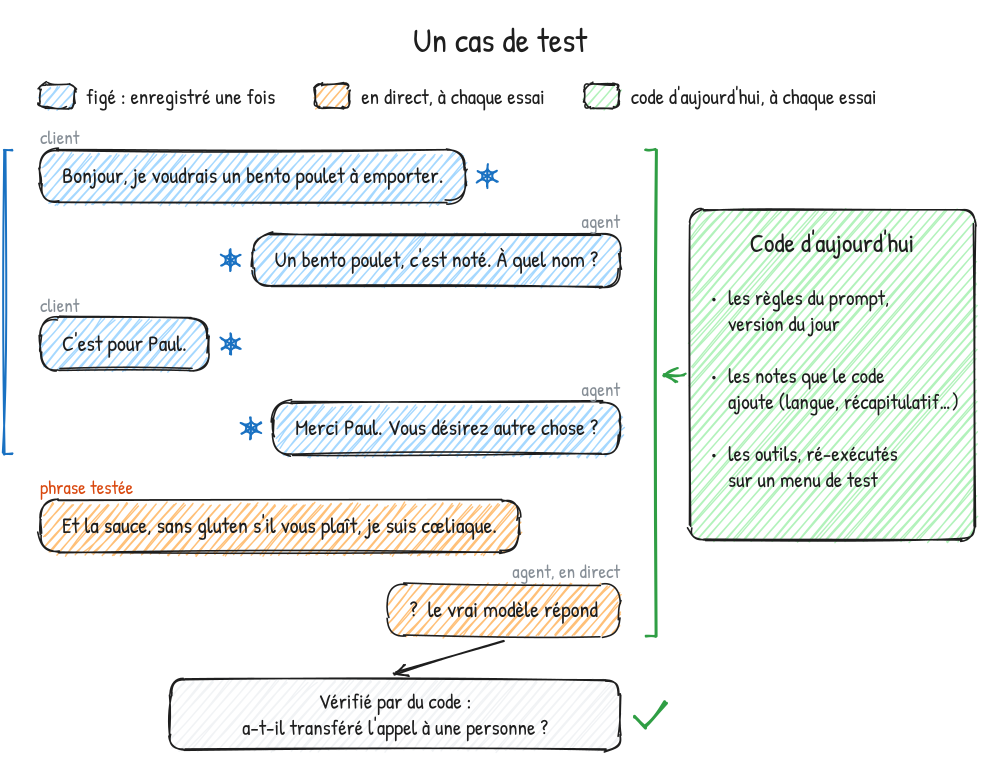
L’historique est enregistré une fois, en parlant avec le vrai agent. Si l’agent se trompe, j’annule la phrase et je la refais : l’historique ne contient aucune erreur, seule la dernière phrase est testée.
Au rejeu, seules les phrases du client et les réponses du modèle sont figées. Tout le reste tourne sur le code d’aujourd’hui : le prompt, ce que le code ajoute à la conversation, les outils. Puis la phrase testée part au vrai modèle. Si je change une règle, c’est la nouvelle règle qu’il lit.
Le contrôle « périmé »
Pour une seule phrase du client, le code peut interroger le modèle plusieurs fois : une fois pour chercher un plat, une autre pour répondre, par exemple. Et le modèle peut répondre vite, ou « réfléchir » d’abord, un mode plus lent que proposent certains modèles.
Pendant le rejeu, chaque fois que le code demande une réponse au modèle, on lui sert la réponse enregistrée. Si le code en demande une de plus, une de moins, ou demande de réfléchir là où le modèle ne réfléchissait pas, l’historique ne correspond plus au code : le cas est périmé, ni réussi ni échoué, et il faut le réenregistrer.
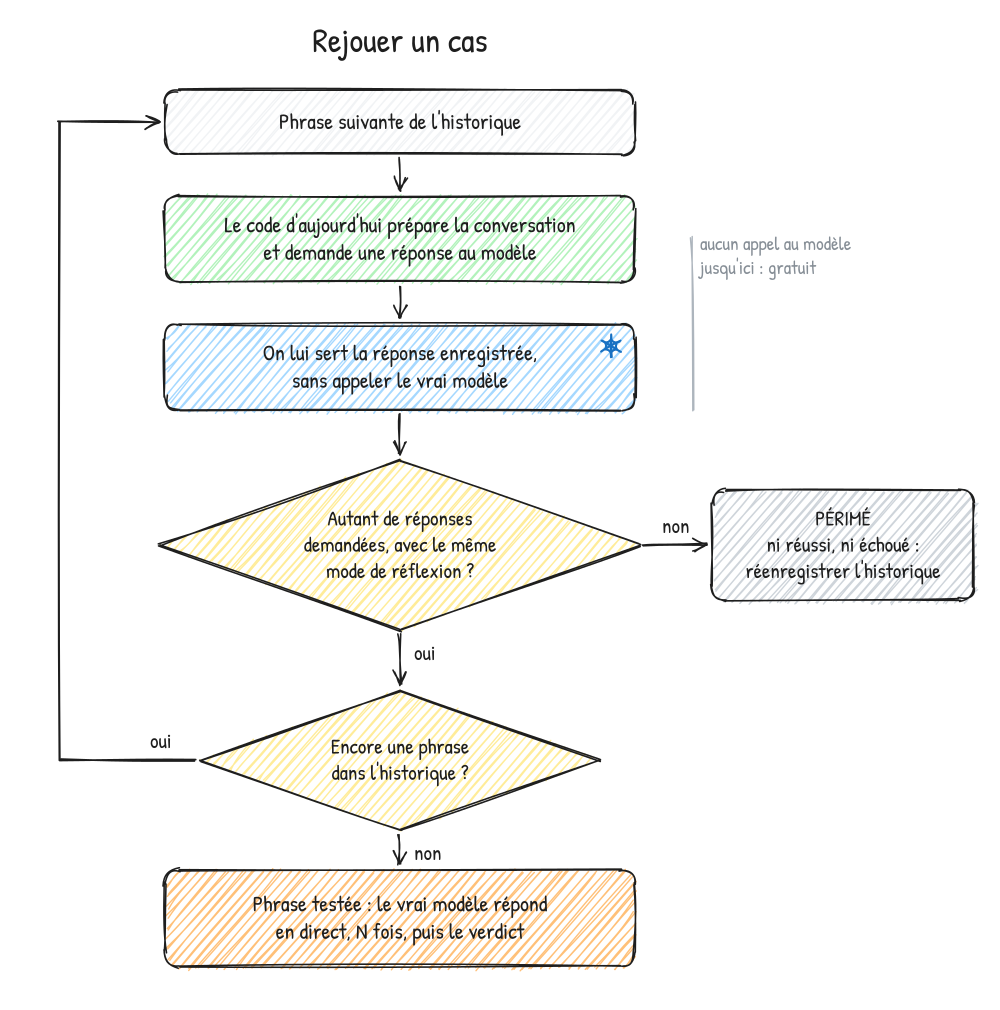
Rejouer l’historique n’appelle aucun modèle : c’est gratuit. Seule la phrase testée appelle le vrai modèle, et donc coûte.
Juger par du code, par paires, plusieurs fois
- Le résultat attendu est vérifié par du code, pas par un autre LLM : tel outil a-t-il été appelé, la commande contient-elle les bonnes lignes ?
- Les cas vont par paires : sur le même historique, une phrase où l’agent doit agir, une où il ne doit pas. Sans la phrase jumelle, un agent qui fait toujours la même chose passerait le test.
- Chaque cas tourne plusieurs fois, et on compare des taux avant et après un changement, à partir des résultats des deux séries :
python -m goldenline compare avant.json apres.jsonC’est ce qui me sert de filet de sécurité. Un ensemble de cas couvre le parcours de tous les jours, une commande simple du début à la fin. Avant chaque modification du prompt, je le lance pour avoir une base ; après, je relance les mêmes cas. compare dit, cas par cas, si une baisse dépasse le simple hasard. Si le résultat recule par rapport à la base, la modification ne passe pas.
Quatre verdicts, pas deux
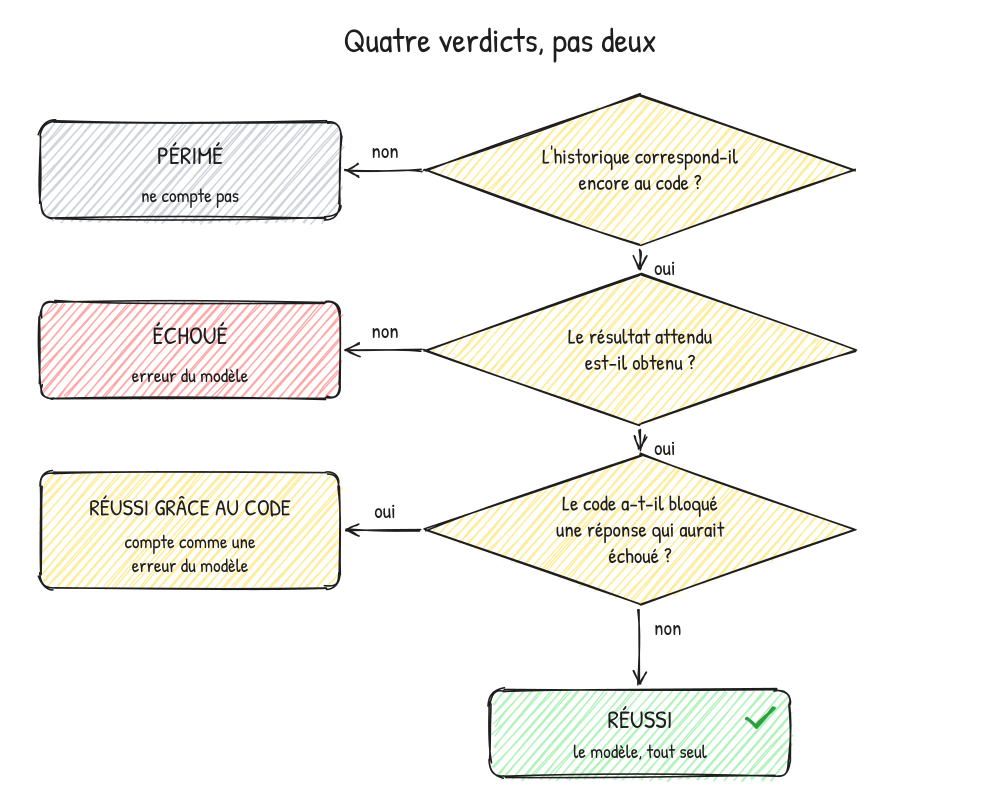
Un résultat obtenu seulement parce qu’un garde-fou a bloqué une mauvaise réponse est compté à part. Pour moi, c’est une erreur du modèle, pas une réussite.
Récapitulatif
| Difficulté | Réponse de goldenline |
|---|---|
| Le modèle varie | Chaque cas tourne plusieurs fois |
| Une correction en casse une autre | Base relancée après chaque changement, comparée cas par cas |
| Appels simulés lents et bruités | Historique figé et propre, une seule phrase |
| Le code rattrape le modèle | Verdict « réussi grâce au code », compté à part |
| Les tests vieillissent | Contrôle « périmé » |
Les limites
Un historique figé ne teste pas ce qui s’accumule sur plusieurs tours, comme un agent qui tourne en rond : pour ça, je garde quelques appels simulés complets. Et tout ne se juge pas par du code : la clarté d’une réponse reste à lire.
Conclusion
Avec un LLM, on ne teste pas une réponse, on mesure un taux. Et pour mesurer un taux sur une seule décision, il faut remettre l’agent exactement dans la même situation, mais avec le code d’aujourd’hui.
Pour essayer, le dépôt contient un petit agent de commande de pizzas avec un modèle simulé : il tourne sans clé d’API et sans rien dépenser. goldenline s’installe aussi comme plugin pytest, et les tests qui appellent un vrai modèle (payant) ne tournent qu’avec --golden-live : la CI ne dépense jamais par accident. C’est une version 0.1, en Python, sans dépendance : goldenline sur GitHub.